📅 最后更新:2026年10月21日 (发布:2025年8月22日)
✅ 审核:有道翻译编辑团队
使用有道翻译网页翻译时,先等目标网页加载完成,再启动整页翻译,并抽查页面各处的译文。翻译长文章则更适合复制原文,按标题和自然段分批处理,完成后按原顺序合并并逐段核对。入口、语言选项和输入限制可能随页面调整,操作时以当前页面显示为准,不要预设固定字数上限。
第一步:区分网页整页翻译和长文章翻译
两种方式处理的内容不同:网页整页翻译面向已打开网页中可识别的文字;文本框翻译处理的是复制粘贴进去的内容。整页翻译不一定覆盖图片中的文字、尚未展开的区域或动态加载内容。
需要了解网页翻译的具体操作,可参考网页内容翻译步骤|有道翻译使用指南。也可以查看有道翻译在线翻译页面|有道,确认当前提供的翻译入口。若页面布局或功能名称有所变化,请以页面实际显示为准。
| 翻译任务 | 输入内容 | 操作方式 | 核对重点 |
|---|---|---|---|
| 网页整页翻译 | 已加载网页中可识别的文字 | 从当前页面提供的网页翻译入口开始操作 | 开头、中段、末尾,以及动态内容区域 |
| 长文章翻译 | 复制到文本输入框的文字 | 按章节、标题和自然段分批粘贴 | 段落顺序、标题、数字和上下文 |
开始前先确认源语言和目标语言。遇到多种语言混排、专有名词或短句时,手动检查源语言选项是否正确。翻译完成后,也要确认译文使用了预期的目标语言。
第二步:等网页加载完成后再翻译
打开目标网页后,先等标题、正文和需要阅读的区域显示出来,再从有道翻译当前页面中选择对应的网页翻译入口。按钮名称和操作路径可能随页面版本变化,因此不要依赖未经核实的固定按钮名称。相关页面信息可从有道翻译网页入口说明|有道翻译查看。
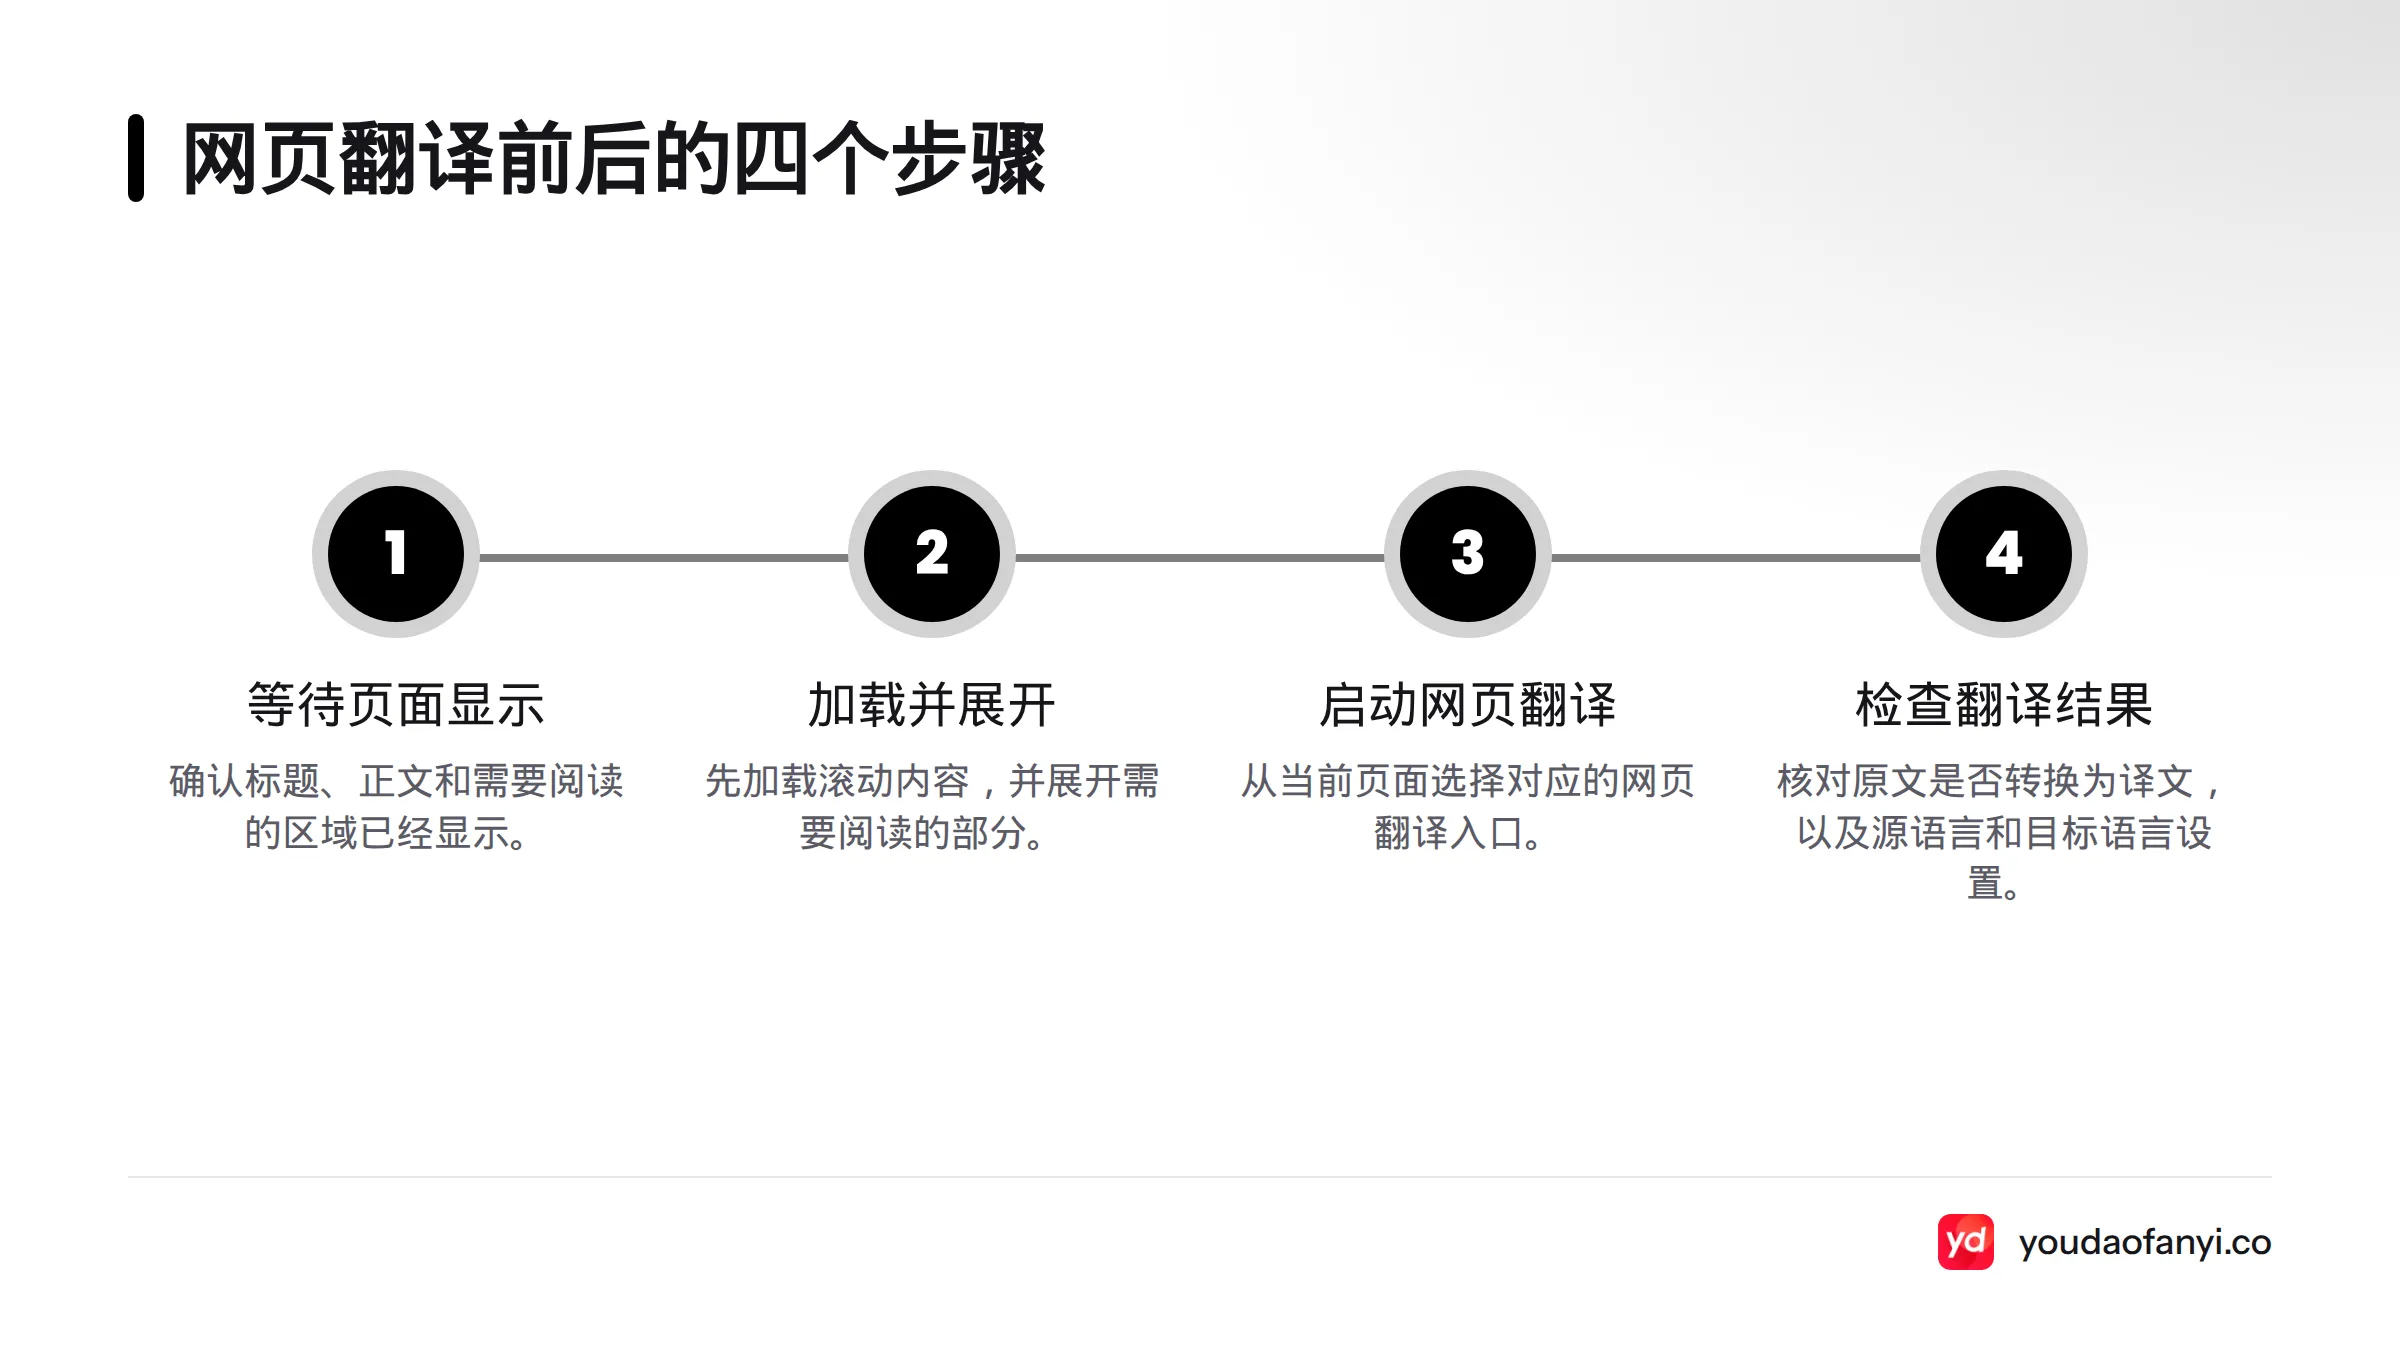
网页仍在加载时启动翻译,新出现的正文可能不会纳入本次处理。等待期间,确认标题、正文和页面末尾已经显示;如果内容需要滚动加载或点击展开,先载入并展开相关部分,再开始翻译。完成后检查原文是否已转换为译文,并核对源语言和目标语言设置。
第三步:抽查网页译文的覆盖情况
不要只检查页面顶部。对照原文,抽查开头、中间和末尾的段落,并查看导航、标题、列表等实际需要阅读的区域。若页面包含滚动加载或点击展开的内容,先载入这些部分再检查。发现仍显示原文、空白或内容缺失时,记下对应位置。
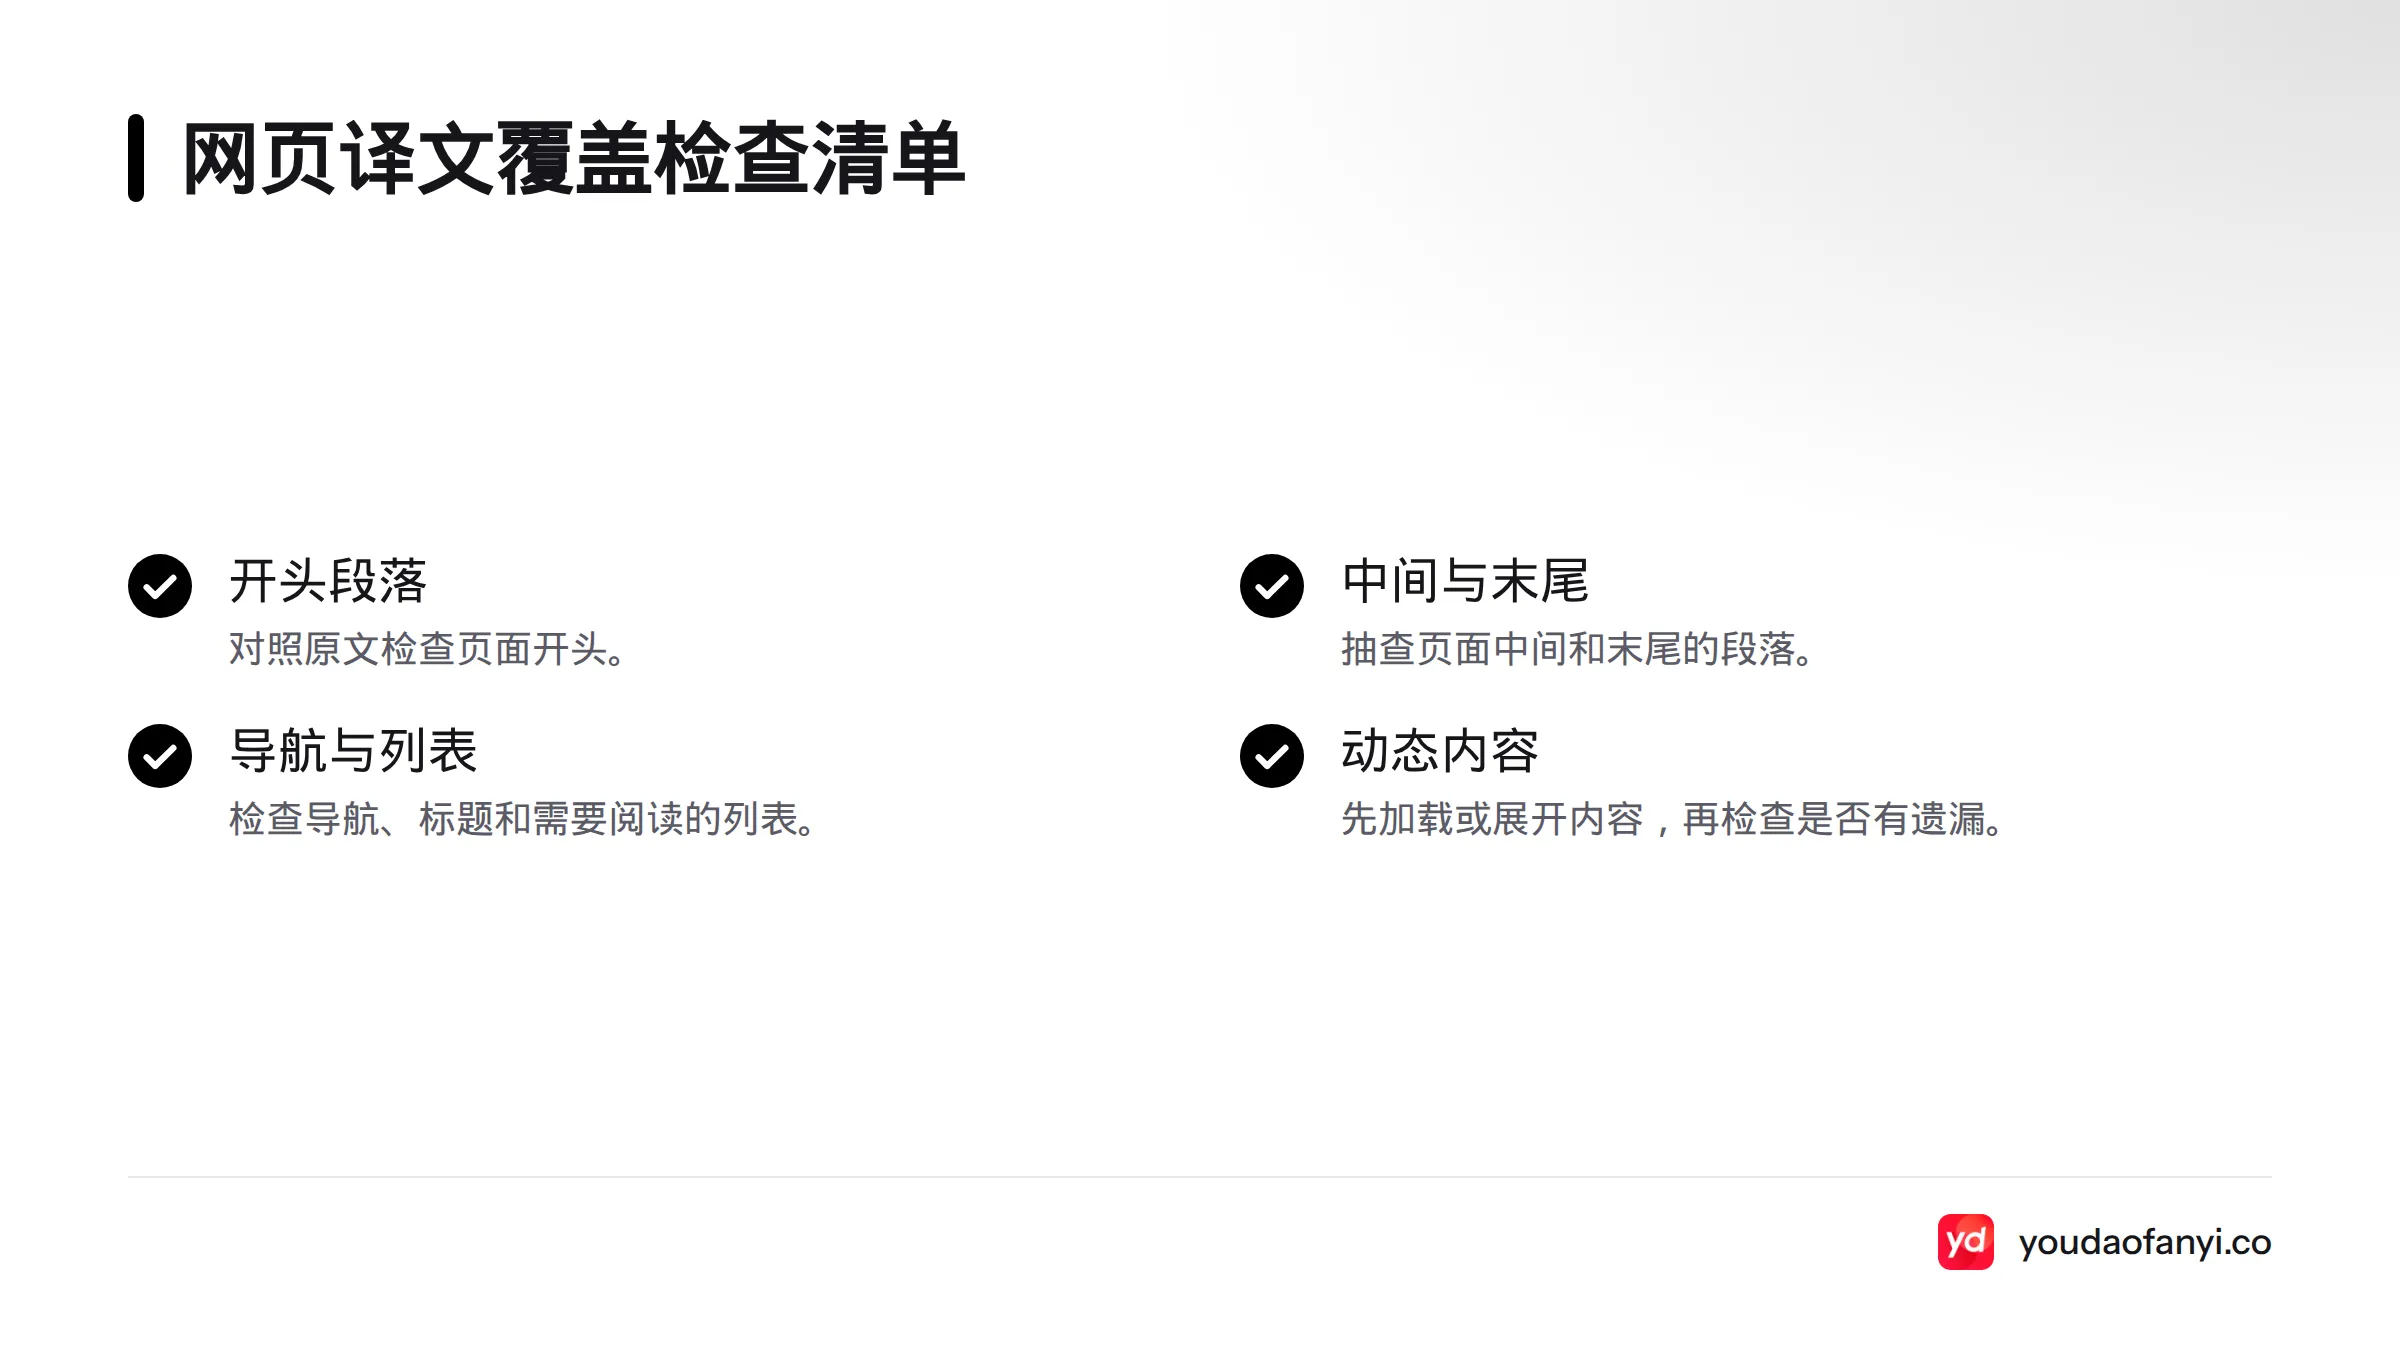
某段没有显示译文,先确认它已经加载或展开,再检查语言方向。若只有部分文字未翻译,可以复制该段到文本输入框单独处理,并与网页原文对照。整页翻译不保证覆盖网页的每个元素;排查空白或翻译不完整的问题时,可参考常见翻译问题排查|有道翻译使用指南。
第四步:按自然段分批翻译长文章
长文章适合按章节、标题和自然段拆分,不要从句子中间截断。句子一旦拆开,代词指向、转折关系和前后语境都可能变得不清楚。复制时保留小标题、列表编号和引文归属,并为每批内容添加定位标记,例如“第二节第3段”。翻译完成后,按原顺序整理译文。
更多长文拆分方法可参考长篇文章翻译操作说明|有道翻译使用指南。
分段核对清单:
- 每批保留原文标题或段落编号。
- 粘贴后检查首句和末句,确认没有漏字或重复。
- 按编号合并译文,不凭记忆调整段落顺序。
- 复查跨段代词、术语和衔接句。
第五步:核对译文,留意输入限制
“字数”和“字符数”并非同一指标,产品页面也可能采用不同的提示方式。不要把未经当前页面确认的数字当成固定上限。提交前查看文本输入框附近的提示;接近提示范围时,缩小每批内容,避免一次粘贴过长。若提交失败或译文缺段,先保留原文副本,再缩短批次重试。
逐段对照原文时,优先检查数字、日期、专名、单位、否定词和列表顺序。机器翻译可以辅助理解,但仍需结合上下文判断。关于机器翻译|维基百科的介绍可供参考。医疗、法律和金融内容应由具备相关专业能力的人复核,不要把机器译文直接当作权威结论。
常见问题:网页与长文章如何翻译
网页整页翻译和文本框翻译有什么区别?
前者处理已加载网页中可识别的文字;后者处理复制粘贴到文本框里的内容。需要精确控制段落并逐段复核时,使用文本框分批处理更便于检查。
网页有些文字没有翻译,怎么办?
先确认相关内容已经加载或展开,再检查语言方向。如果仍未翻译,复制该段单独处理,并与原网页核对。
长文章按什么边界拆分?
优先按章节、标题和自然段拆分,保留列表和引文,不要截断句子。用段落编号定位,翻译后按原顺序合并。
输入超过页面提示范围或提交失败,怎么办?
不要猜测固定字数上限。根据页面提示缩小批次,保留原文并检查每批的开头和结尾,确认译文没有缺段后再继续。
如何检查语言方向和译文?
核对源语言和目标语言,再逐段检查数字、专名、否定词及上下文。若页面入口或语言选项发生变化,以有道翻译当前页面显示为准。